





worker_processes 应设为物理核心数或 auto,但在arm架构银河麒麟系统中需结合nproc --all与lscpu确认实际物理大核数,反向代理场景建议设为物理核数的0.75倍,容器化环境须按cgroup配额核数设置,并同步配置use epoll;、worker_rlimit_nofile 65536;和worker_connections 8192;。
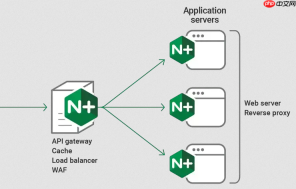
直接设为 auto 是最稳妥的起点,但 ARM 架构(尤其在银河麒麟系统上)需结合物理核心数、负载类型和容器环境做针对性微调,不能简单套用 x86 经验。
优先用 auto,但要确认它读的是物理核数
ARM 服务器常启用 big.LITTLE 或异构核心(如 Cortex-A78 + A55),而 worker_processes auto; 在较新 Nginx 版本(1.21+)中默认读取 /proc/cpuinfo 中的 processor 行数——这可能是逻辑核总数,含小核或超线程。在银河麒麟系统上建议先执行:
-
nproc --all:看系统报告的总逻辑核数 -
lscpu | grep "Core(s) per socket\|Socket(s)":算出物理核心总数(Socket × Core per Socket) - 若两者差异大(如 8 逻辑核但仅 4 物理大核),应手动设为物理大核数,例如
worker_processes 4;
根据典型 ARM 负载场景动态调整
ARM 服务器常见于边缘计算、轻量 API 网关或国产化信创环境,I/O 和内存带宽往往比 CPU 更早成为瓶颈:
- 反向代理为主(如对接 Java 微服务或 WebSocket):设为物理核心数的 0.75 倍(如 4 核设为 3),减少每个 worker 维持长连接带来的内存与文件描述符压力
- 静态资源服务(HTML/CSS/JS)且启用了
sendfile和tcp_nopush:可设为物理核心数(如 4 核 → 4),并开启multi_accept on;提升吞吐 - 运行在 Kubernetes 容器中:必须以 cgroup 为准,检查
cat /sys/fs/cgroup/cpu/cpu.cfs_quota_us和cpu.cfs_period_us,算出实际配额核数(如 quota=200000, period=100000 → 2 核),再设对应值
配套关键参数必须同步优化
只改 worker_processes 效果有限,ARM 平台还需明确指定高效事件模型并控制资源上限:
- 显式声明
use epoll;(Linux 内核原生支持,ARM 麒麟也适用),避免 Nginx 自动探测开销 - 设置
worker_rlimit_nofile 65536;,并在系统级执行ulimit -n 65536,否则高并发下会因文件描述符不足报错 -
events { worker_connections 8192; multi_accept on; },使单 worker 连接能力匹配 ARM 多核处理潜力
慎用 worker\_cpu\_affinity,除非有明确收益
ARM 架构下缓存一致性策略与 x86 不同,盲目绑定可能适得其反:
- 仅当压测发现某几个核心持续高负载(>80%)、其余核心闲置明显时,才考虑用
worker_cpu_affinity分散绑定 - 例如 4 核 ARM 服务器,可写为
worker_cpu_affinity 0001 0010 0100 1000;,确保每个 worker 独占一个物理核 - 若服务器启用了 big.LITTLE,不建议跨簇绑定(如不让 worker 同时跑在 A78 和 A55 上),优先绑定到大核簇



