





关键在于识别并阻断异常连接复用行为,如后端不响应keepalive、nginx误判连接可复用却长期滞留等;需结合ss/netstat统计、error_log分析、debug日志验证、收紧keepalive超时与请求数限制、启用主动健康检查及配置资源硬限与告警。
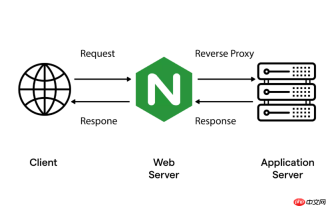
要监控 upstream 连接池泄漏、防止因连接堆积引发的拒绝服务(DoS),关键不是“防攻击”,而是识别并阻断异常连接复用行为——比如后端不响应 keepalive、Nginx 误判连接可复用却长期滞留、或 worker 进程未及时清理空闲连接。这类问题常表现为内存缓慢上涨、ESTABLISHED 连接数持续攀升、新请求建立失败,最终耗尽 socket 资源。
观察连接池真实占用与空闲连接生命周期
Nginx 不暴露连接池内部计数的原生指标,需结合系统层 + 配置约束 + 日志线索交叉验证:
- 用 ss -s 或 netstat -an | grep :upstream_port | grep ESTAB | wc -l 统计到每个后端地址的活跃 TCP 连接数,对比 keepalive N 设置值(例如
keepalive 32表示每个 worker 最多缓存 32 条空闲连接);若实际 ESTABLISHED 数远超N × worker_processes,说明连接未按预期释放 - 检查 error_log 中是否高频出现
upstream connection is busy或no live upstreams,这往往意味着连接池被无效连接占满,新请求无法获取连接 - 启用 ngx_http_upstream_keepalive_module 的 debug 日志(编译时加
--with-debug,配置中设error_log /path/to/error.log debug;),搜索keepalive free和keepalive close日志行,确认空闲连接是否真被放回池中,以及是否触发了dummy_handler超时关闭
收紧 keepalive 行为与超时策略
连接池泄漏常源于 keepalive 条件宽松或超时设置不合理,导致连接“挂起”而非释放:

- 显式设置 keepalive_timeout(如
keepalive_timeout 15s;),避免依赖默认 60s;该值应略大于后端真实响应间隔,但不超过业务容忍范围 - 限制单连接复用请求数:keepalive_requests 100;(默认 100),防止长连接承载过多请求后状态异常,难以回收
- 确保后端返回标准 keepalive 响应头:HTTP/1.1 必须含
Connection: keep-alive,且响应体完整(无截断);若后端是 HTTP/1.0,需强制添加add_header Connection keep-alive; - 禁用不必要协议兼容:在 upstream 块中明确指定
type=http;(非 tcp),避免因协议误判跳过 keepalive 检查逻辑
通过主动健康检查暴露连接异常
被动式 upstream(默认)只在请求失败时摘除节点,无法发现“连接能建但不响应”的半死状态。必须引入主动探测:
- 使用 tengine 的 upstream_check 模块(推荐)或第三方模块如
nginx_upstream_check_module,配置check type=http interval=5s fall=2 rise=2 timeout=2s; - 健康检查请求应模拟真实流量路径(如带相同 Host、路径、必要 header),并校验 HTTP 状态码(如
check_http_send "GET /health HTTP/1.1\r\nHost: backend\r\n\r\n"; check_http_expect_alive http_2xx;) - 当某 server 被标记为 down 后,观察其对应连接池是否快速清空(
ss输出中该地址 ESTABLISHED 数归零);若仍残留大量连接,说明连接解绑逻辑失效,需检查模块版本或配置冲突
配置资源硬限与告警阈值
仅靠日志和命令行排查滞后,需构建可观测闭环:
- 在 Prometheus + Grafana 环境中,采集 nginx_ingress_controller_upstream_latency_seconds(延迟突增)、nginx_ingress_controller_connections(当前活跃连接)、process_open_fds(文件描述符使用率)等指标
- 设置告警规则:例如 “过去 5 分钟内,某 upstream 地址的 ESTABLISHED 连接数 >
keepalive × worker_processes × 1.5且持续上升”,或 “nginx_ingress_controller_connections> 90% of ulimit -n” - 对关键 upstream 添加 max_conns 限制(如
server 10.0.0.1:8080 max_conns=200;),超出后直接拒绝新连接(返回 503),避免雪崩扩散


