





sql语句蕴含丰富技巧,除了基本的增删改查操作外,还涵盖多种高级语法和性能优化方法。
1、我所使用的操作系统为64位Windows 7,因此安装了对应架构的SQL Server 2008 R2版本。
2、安装前请务必确认系统类型:32位系统应选用32位SQL Server安装包,版本兼容性良好,如SQL Server 2005或2012均可顺利部署并运行。
3、安装完毕后,可通过“开始菜单”快速定位到相关程序。
4、找到目标程序后,可右键选择“发送到→桌面快捷方式”,便于后续快速访问。

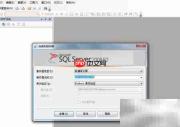
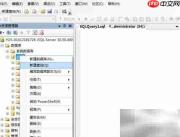
5、在数据库节点上右键,选择“新建查询”以创建新的SQL脚本文件。
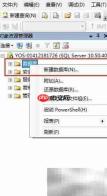
6、弹出新建文件对话框后,请参照图示完成相应配置。
7、建议将数据库文件路径指定至非系统盘(如D盘或E盘),并在该位置新建专用文件夹用于集中管理。
8、若将大型数据库文件直接存放在C盘,将明显拖慢整机响应速度与磁盘I/O效率。
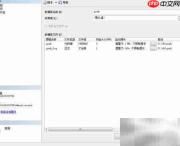
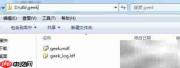
9、完成设置后,目标文件夹中会自动生成两个关键文件。
10、此后所有针对该数据库的操作,本质上都是对这两个物理文件的读写与维护。
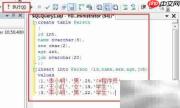
11、在新建数据库下右键点击“新建查询”,使用T-SQL语句创建数据表,并插入若干测试记录。
12、建表既可通过编写CREATE TABLE语句实现,也可借助图形化界面中的“设计表”功能完成。
13、以下操作仅适用于SQL Server 2008及更高版本。
14、 (
15、 );
16、李小明,男,25岁,职业为C语言开发工程师。
17、王小红,女,19岁,在校学生,编号为2。
18、李小明,男,22岁,在校学生,编号为3。
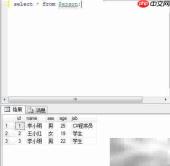
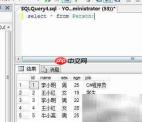
19、执行一条SELECT语句,一次性检索出此前插入的所有数据。
20、结果集清晰展示了各字段的具体内容与结构。
21、接下来我们将使用GROUP BY子句对数据进行分组处理。
22、先来看该语句的标准语法格式。
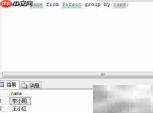
23、从执行结果可见,数据已成功按“姓名”字段完成归类整合。
24、换言之,该操作实现了对重复值的有效剔除。
25、比如数据库中已有50条员工信息录入。
26、若按“所属公司”字段进行分组,则可快速统计出这50人分别隶属于多少家不同企业。
27、上述SQL语句提取了第二列内容,并自动过滤掉其中的重复项。

28、我们还可结合COUNT()等聚合函数,统计每组数据的出现频次。
29、下图直观呈现了聚合函数在实际应用中的强大能力。
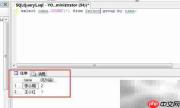
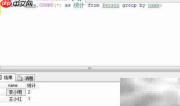
30、此外,支持通过AS关键字为计算列或表达式指定更具可读性的别名。
31、按姓名分组后,统计每个名字对应的记录数量。
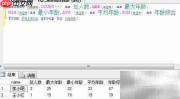
32、查询每位人员的姓名,同时返回其所在组的人数总数及最大年龄值。
33、同理,还能获取最小年龄、平均年龄以及年龄总和等统计指标。
34、全新升级的功能模块,助力深度解析SQL语句逻辑与执行效果。
35、当然可以!我们再追加几条新数据,进一步演示更复杂的分析场景。
36、欢迎各位读者同步添加更多样例数据,增强实践体验。
37、筛选出姓名重复出现次数不少于两次的记录。
38、HAVING子句配合聚合函数使用,可精准限定分组后的筛选条件。
39、更多进阶SQL语法与实战技巧,将在后续文章中深入展开。





