





limit_req_zone仅适合作为入口兜底,千万IP限流需分层架构:内存硬瓶颈致其无法支撑;分布式层用Redis Cluster+滑动窗口实现精准控制;通过热/温/冷IP分级采样将活跃key压至几十万量级。
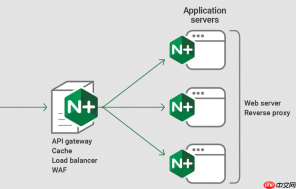
limit_req_zone 是 Nginx 原生支持的限流模块,但它本质是单机能力,无法直接支撑分布式架构下千万级 IP 的精细化限流。强行用它处理千万 IP,会因内存爆炸、状态不共享、维度缺失等问题导致系统不可用。真正可行的方案,是以 limit_req_zone 为入口网关轻量兜底,再叠加分布式限流层做核心控制。下面从三个关键环节讲清楚怎么做:
内存计算模型本身有硬瓶颈,不能扛千万 IP
Nginx 的 limit_req_zone 使用「共享内存区(shared memory zone)」存储每个 key(如 $binary_remote_addr)的计数器。其内存开销可粗略估算为:
- 每个 key 占用约 128 字节(含哈希桶、计数器、时间戳、锁等元信息);
- 若需支持 1000 万独立 IP,仅 key 存储就需:10⁷ × 128 B ≈ 1.28 GB;
- 实际还需预留哈希冲突冗余、zone 扩容空间、多 worker 共享开销,2–3 GB 内存只是起步;
- 更严重的是:IP 数持续增长时,zone 无法动态扩容,只能重启 Nginx —— 违反高可用原则。
所以,limit_req_zone 适合做「粗粒度、低基数、高吞吐」的前置过滤(如限制单 IP 短时高频扫描),绝不能作为千万 IP 维度的唯一或主限流手段。
分布式限流层必须承担 IP 维度的精准管控
要实现千万级 IP 的精细化限流(例如:每个 IP 每分钟最多 60 次 / 每小时最多 500 次 / 异常行为实时拦截),必须引入外部分布式状态中心。推荐组合:
-
存储选型:Redis Cluster(非单实例),启用
MEMORY优化 +LFU驱逐策略,避免冷 IP 占满内存; -
Key 设计:
ip:123.45.67.89:minute:1717000000(带时间戳分片),配合 Lua 脚本保证原子性; - 滑动窗口支撑:用 Redis Sorted Set 或位图(bitfield)记录每 100ms 的请求时间戳,实现秒级精度的“最近 60 秒请求数”统计;
-
降级兜底:当 Redis 不可用时,自动 fallback 到
limit_req_zone的本地令牌桶(如burst=5 nodelay),保障基本防护不中断。
这样,Nginx 只负责快速转发 + 简单拒绝,重载逻辑全由后端限流服务承担,既解耦又可水平扩展。
精细化 ≠ 全量记录,必须分层聚合与采样
千万 IP 全量精确计数成本极高。生产中应采用「分级响应 + 动态采样」策略:
- 热 IP 全量跟踪:对近 5 分钟内请求 ≥ 10 次的 IP,升格为高优先级 key,走完整滑动窗口统计;
-
温 IP 概率采样:对中低频 IP,按 1%–5% 概率写入限流系统(如
rand() 才进 Redis),大幅降低存储压力; -
冷 IP 兜底限流:对长期无请求的 IP,不建 key,靠 Nginx 的
limit_req zone=global burst=10统一控速; -
行为标签加速决策:在用户首次请求时,通过风控服务打标(如
risk_level:high),后续直接查标签走不同阈值策略,避免每次重算。
这套机制让系统实际承载的活跃 key 数控制在几十万量级,而非千万,内存和延迟都可控。
不复杂但容易忽略


