





在 deepseek-v4 发布并引发业界广泛关注仅五天后,deepseek 官方正式启动多模态图像理解功能的灰度测试,标志着其多模态能力正式迈入实际应用阶段。本次升级已在移动端与网页端输入框中新增“识图模式”入口,并醒目标注“图片理解功能内测中”,实现了从单一文本/代码交互向图文融合交互的关键跃迁。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
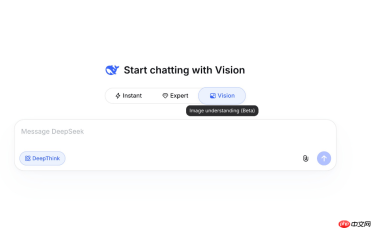
实测结果表明,DeepSeek 在基础图像解析与场景描述方面展现出较强实力。面对包含多个人物、复杂环境布局及精细摄影质感的画面,模型可生成高度贴合原图语义的描述文本;启用“思考模式”后,其逻辑推演能力进一步凸显,能依据文物的造型特征、纹饰细节与材质表现,准确判断所属艺术流派及所处历史时期。同时,在图像文字识别(OCR)与上下文场景推理方面,整体表现已达到当前主流多模态模型的平均水平。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
不过,在应对高难度视觉任务时,该模块仍有待完善。测试发现,当图像存在严重碎片化、负片效果或强干扰噪声时,识别稳定性有所下降;在物体数量统计、嵌套几何关系分析等需强空间建模能力的任务中,虽可见模型尝试类“自我辩论”式的分步推理,但最终准确率与响应速度尚有提升空间。此外,对于近期刚发布的产品或极小众新事物,识别覆盖度仍受限于知识库的更新节奏。
业内观点认为,当前功能形态更倾向于以插件方式集成至主模型的视觉理解组件,核心目标是借由灰度验证多模态数据通路的完整性与鲁棒性。伴随 DeepSeek 视觉补丁版本的高频迭代,国产大模型在原生多模态领域的竞争焦点正加速由“参数量比拼”转向“全维度感知力构建”。此次内测不仅填补了 DeepSeek 在多模态能力上的关键空白,也释放出其原生多模态大模型即将全面上线的重要信号。



