






4月29日,科大讯飞正式推出全新升级的星火x2-flash大模型,并同步开放api服务,标志着依托国产算力生态的大模型应用迈入高效能新纪元。
该模型采用当前业界广泛采用的MoE(混合专家)架构,整体参数规模达30B,其最突出的能力之一是支持最长256K的上下文长度。尤为关键的是,星火X2-Flash全程基于华为昇腾910B芯片集群完成训练,充分印证了国产软硬件在大规模深度学习训练任务中的深度融合与协同实力。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
在关键能力维度上,星火X2-Flash在智能体(Agent)构建与代码生成两大方向实现跨越式提升。据权威第三方实测结果表明,该模型在深度行业研报解析、Skill编排与动态调用、系统级指令执行等高复杂度任务中,综合表现已可媲美国际一线万亿参数量级的头部大模型。
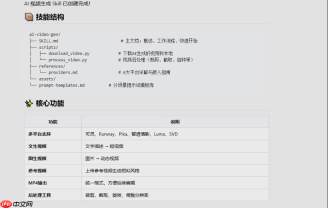
聚焦开发者实际关切的成本问题,星火X2-Flash展现出显著优势。在统一工作流基准测试中,其Token消耗仅为当前主流大参数模型的约三分之一,大幅降低了构建高性能智能体应用的技术与经济门槛。以复杂视频生成技能开发为例,模型不仅能精准捕捉用户意图,还可结构化输出从技能设计逻辑、模块划分到核心函数实现的完整说明。

在底层技术创新层面,星火X2-Flash首次在国产AI芯片平台上实现了DSA(稀疏注意力机制)与MTP(多Token并行预测)技术的深度融合。该突破有效攻克了长文本在国产算力环境下的训练效率瓶颈,相较同规模训练集群,整体训练速度提升达4.5倍。此外,面向智能体强化学习场景,模型通过算法策略优化与系统工程调优双路径协同,将采样与推理效率提升超2倍,切实缓解长轮次交互过程中的响应延迟与资源占用压力。
目前,AstronClaw、Loomy等前沿应用已完成快速集成。同时,该模型已深度适配OpenClaw、Claude Code等国际主流Agent开发框架,为全球开发者提供兼具先进性、稳定性与高性价比的国产AI算力新选择。





