





$request_id是全链路日志追踪的起点,因其在Nginx请求进入时自动生成且贯穿整个生命周期,但需显式输出到日志并透传至后端才能实现跨服务关联。
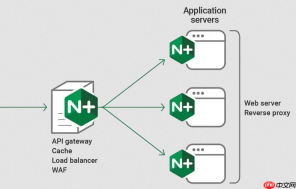
为什么 $request_id 是全链路日志追踪的起点
Nginx 的 $request_id 变量在请求进入时自动生成(UUID v4),只要不被覆盖或丢弃,就能贯穿整个 Nginx 生命周期。它不是“可选功能”,而是开箱即用的字段——但默认不会输出到日志里,也不会透传给后端服务。如果你没在 log_format 里显式引用它,或者没通过 proxy_set_header 转发出去,那这个 ID 就只活在 access log 的某一行里,对下游服务和 ELK 毫无价值。
关键点在于:它必须从入口网关开始“带出来”,并在每跳服务中持续传递、记录。
在 Nginx 中正确输出并透传 $request_id
要让 $request_id 真正可用,得同时做两件事:写进 access log,再发给后端。
- 在
http块定义日志格式时加入$request_id,例如:log_format main '$remote_addr - $remote_user [$time_local] "$request" ' '$status $body_bytes_sent "$http_referer" ' '"$http_user_agent" "$http_x_forwarded_for" ' '$request_id $upstream_http_x_request_id'; - 在
location或upstream配置中透传该 ID:proxy_set_header X-Request-ID $request_id;
(注意:别用X-Request-Id这种大小写混用写法,部分语言客户端/框架对 header 名大小写敏感) - 如果后端是 Java Spring Cloud,还需确保
FeignClient或RestTemplate主动读取并复用该 header,否则下游服务收到的是新生成的 ID
ELK 侧如何提取和关联 request_id 字段
Logstash 或 Filebeat 收集 Nginx 日志时,$request_id 是普通字符串字段,但它的价值只有在所有服务日志中保持同名、同格式才能被聚合分析。

- Filebeat 的
processors或 Logstash 的grok必须把日志行中的$request_id提取为统一字段名,比如trace_id(推荐与 OpenTracing / OpenTelemetry 对齐) - 务必检查提取后的值是否含空格或换行符——Nginx 默认不 trim,某些日志行末尾可能多一个空格,导致 Kibana 中无法关联
- Java 应用打日志时,应使用 MDC(Mapped Diagnostic Context)注入
trace_id,例如:MDC.put("trace_id", request.getHeader("X-Request-ID")),再配合 logback 的%X{trace_id}输出到日志文件 - Elasticsearch 的索引模板中,建议将
trace_id映射为keyword类型,避免分词导致聚合失效
常见断裂点:哪些地方 request_id 会“消失”
全链路最脆弱的不是 Nginx,而是中间那些看似无关的环节。
- 异步任务(如 RabbitMQ 消费者、定时 Job)不会自动继承 HTTP 请求的 header,必须在投递消息时手动把
X-Request-ID作为消息属性或 payload 字段带上 - 跨语言调用时,Go 的
net/http默认不转发自定义 header,Python 的requests也不自动透传,需显式设置 - Nginx 子请求(subrequest)、内部重定向(
internallocation)会生成新的$request_id,若需延续,得用set $req_id $request_id;+proxy_set_header手动携带 - CDN 或 WAF 层可能过滤或重写
X-Request-ID,要确认它们是否支持透传,或改用更稳定的X-Correlation-ID并在 Nginx 中做一次映射
Nginx 的 $request_id 本身很轻量,但它像一根线,串起所有日志的前提是——每个经手方都愿意把它接住、不丢、不改、不藏。最容易被忽略的,往往不是配置怎么写,而是某个异步回调函数里忘了从上下文取 ID,或是某次 curl 测试直接绕过了 Nginx。


