





nginx默认不重试post等非幂等请求,因http协议要求保守处理;启用non_idempotent需同时配置proxy_request_buffering off且仅对连接层失败有效,生产环境应避免使用,改由业务层通过幂等键(idempotency-key)实现可靠提交。
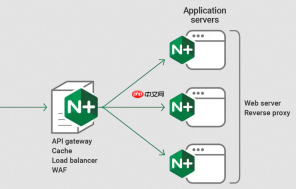
不要对 POST 开启 non_idempotent,除非你已确认上游服务完全幂等且重试逻辑被端到端验证过。 这是生产环境最常被误用、后果最严重的配置之一——它会让一次前端提交,在后端触发多次创建、扣款或发信。
为什么 non_idempotent 默认不生效
Nginx 对非 GET/HEAD 请求(如 POST、PUT、DELETE)默认禁止重试,这是基于 HTTP 幂等性原则的保守设计。即使你写了 proxy_next_upstream error timeout http_502; non_idempotent;,Nginx 仍会检查:请求是否已部分发送到上游。若已发送,重试即被跳过——除非你同时禁用缓冲:
-
proxy_buffering off;(关闭响应体缓冲) -
proxy_request_buffering off;(Nginx ≥ 1.7.11,禁用请求体预读;否则 POST body 会被缓存并重复发送)
但这两项关闭后,Nginx 就无法处理大请求体、无法做 header 重写、也无法支持 HTTP/2 流控,属于“为重试牺牲基础能力”的高风险操作。
non_idempotent 触发的真实条件
它不是“只要加了就重试 POST”,而是仅在满足以下全部条件时才可能介入:
- 错误发生在
proxy_pass阶段早期:比如建连失败(error)、连接超时(timeout),且请求体尚未开始发送 -
proxy_request_buffering off;已启用(否则 Nginx 会缓存整个 POST body,重试时直接复用,但此时已失去对上游是否接收的判断) - 上游未返回任何响应(即没走到
invalid_header或http_502等可捕获状态)
换句话说:non_idempotent 只兜底“连接层失败前的 POST”,对“上游已收请求但处理超时/崩溃”完全无效。而现实中,这类问题更常见。

FastAPI + Flask 混合部署最佳实践,解决路由定义、API 代理等常见问题,适用于同时运行 FastAPI API 与 Flask 前端的场景。
比开启重试更安全的替代方案
真正需要保障 POST 可靠性的场景,应绕过 Nginx 层重试,改由业务层控制:
- 前端提交前生成唯一
idempotency-key(如 UUID),通过X-Idempotency-Keyheader 透传 - 后端在收到 POST 时先查该 key 是否已存在成功记录,存在则直接返回原结果(HTTP 200 + 原 body)
- Nginx 仅保留默认
proxy_next_upstream error timeout;,专注处理网络层故障,不碰业务语义 - 对长耗时操作(如 Excel 导入),强制走异步:前端提交后立即返回 task_id,再轮询
/task/{id}获取结果
这样既避免 Nginx 重试引发的副作用,又让幂等性逻辑集中在业务可控范围内。
如果非要测试 non_idempotent 行为
仅限开发环境验证链路,务必配合日志与上游埋点:
- 在 upstream 中配两台后端,并让其中一台监听但不响应(如
nc -l 8080后直接 Ctrl+C 模拟连接拒绝) - 用
curl -X POST --data "a=1" http://gateway/test发请求,观察 access log 是否出现同一 request_id 在两台机器上各记一次 - 检查后端 access log 中的
X-Forwarded-For和X-Real-IP,确认是否真为同一客户端 IP 发起的两次独立请求(而非 Nginx 复用连接)
注意:一旦发现日志中某次 POST 出现两次 200 响应,或数据库插入双记录,说明幂等未落地,non_idempotent 就不该上线。
最易被忽略的一点:Nginx 的重试是无状态的,它不感知业务含义。你配置了 http_500,它就重试;但上游返回 500 可能是数据库死锁,重试只会让死锁更频繁。真正的容错不在网关,而在服务自身能否快速失败、降级或排队。


