





4月16日晚,openai悄然发布了全新图像生成模型——gpt-image-2。尽管目前仅处于灰度测试阶段,尚未全面开放,但当我首次目睹其输出结果时,并未脱口而出“这张图真美”,而是一种近乎本能的震撼:它已不再像传统意义上的ai绘图,反倒更接近一张真实设备截取的屏幕画面。
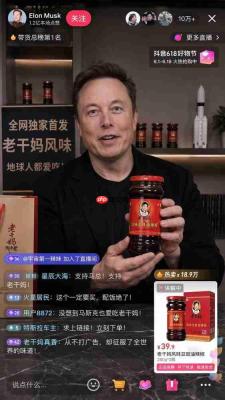
使用GPT-image-2生成
这话听来或许略显激进,但若你长期沉浸于各类AI图像工具之中,便会立刻领会其中分量之重。
过去数年,AI绘图能力突飞猛进:能精准刻画人像、渲染高质感产品图,亦可依托参考图完成风格迁移与创意延展。然而对资深用户而言,观图时总不自觉带着一份“侦探心态”——尤其面对人物图像,会本能审视手指是否畸形、眼神是否空洞、文字是否错乱、光影是否违和、细节是否透出一股难以言喻的“虚假感”。
不真实的AI图片
不少AI作品初看惊艳夺目,可稍作凝视,便容易触发“果然被我发现了”的微妙心理。或是整体过于平滑,泛着塑料般的光泽;或在画面边缘突兀冒出无法识别的字符、不合逻辑的手势、断裂的肢体结构……归根结底,旧有模型产出的图像始终萦绕着一层挥之不去的“AI烙印”,随之而来的是“失真”、“廉价”、“工业化流水线”等潜意识标签。
而GPT-image-2,彻底打破了这一惯性认知。
我输入的提示词极为简洁:“生成一张女主播抖音截图。” 全文仅11字,未附加任何修饰性描述。正因如此,才更能检验模型对语义的深层理解力。“女主播抖音截图”并非一个静态视觉对象,它背后承载着人物形象、直播界面UI规范、中文文本系统、手机截图特有的噪点与比例,以及大众对短视频生态的集体记忆。
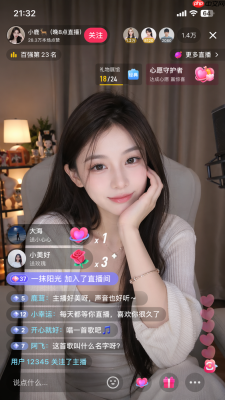
使用GPT-image-2生成
换言之,这不是让AI画一位美女,而是让它构建一个“仿佛真实发生过的数字现场”。
这项任务难度极高。
首先是人物表现力。
过往AI生成人像常陷于两极:一端是过度理想化的“完美脸蛋”,失真到令人出戏;另一端则是结构崩坏——手部扭曲、骨骼错位、五官比例失调,经不起细看推敲。而本次生成的女主播,面部神态、手指姿态、身体动势均高度自然。她宛如一位开启美颜滤镜、打准环形灯、端坐于真实直播间镜头前的职业主播:皮肤纹理、妆容层次、面光与眼神高光、背景轻微虚化等细节,悉数被模型精准捕捉。
真正高级的拟真,并非一味追求极致精致,而是贴合现实语境中的“合理之美”。现实中直播间不是电影布景,它融合美颜算法、环境灯光、实时互动带来的微小瑕疵与亲切感。GPT-image-2之所以令人惊叹,正在于它将这些复杂维度统一还原了出来。
其次是界面逻辑还原度。
多数AI模型并不真正“懂”抖音直播间——它们知道该有主播、弹幕、点赞图标、礼物特效与互动按钮,但这些元素往往被机械堆砌,缺乏真实App应有的秩序感。真实应用界面中,头像位置、昵称排布、评论滚动节奏、功能按钮层级、输入框定位、顶部导航与底部操作栏的空间关系,皆遵循严格的设计语言与交互逻辑,并非随意摆放。
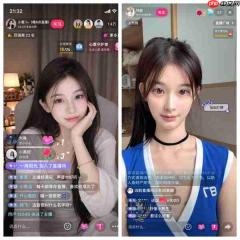
右侧为真实直播间截图
再来看一张真实抖音直播间截图。对比之下即可发现,新模型已深度理解该场景的结构范式:它清楚一张直播间截图应有的视觉构成,也熟知各UI组件的大致落点。你不会觉得它是在“拼凑一个叫‘直播间’的符号”,而是真切复现了一个你曾在刷屏中无数次见过的界面形态。
当然,它并非毫无瑕疵。若以专业UI设计师标准严苛审视,仍可发现个别区域比例偏差、部分控件间距略异于真实App等细节问题。但这些已不属于“一眼识破”的硬伤,而是必须暂停、放大、逐像素比对真实截图后,才可能察觉的细微出入。
这,正是质变的临界点。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
最令我意外的,还有其对中文文本的驾驭能力。
长期以来,中文一直是AI图像生成中最易“翻车”的环节。许多模型能绘制精美画面,却在中文出现时瞬间崩塌:或呈现乱码式字符,或笔画缺失残缺;稍好者虽字形完整,却扭曲变形,形似中文实则不可读。而在直播间这类高频中文场景中,评论区、昵称、按钮文案、系统提示等文字密度极高,任一局部失准,整张图的真实感即刻瓦解。
GPT-image-2此次的表现,已远超预期。
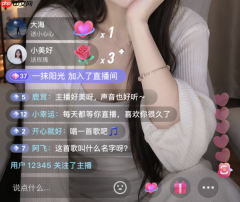
中文字符精准 且贴合直播间场景
它能生成完全合规、语义通顺、符合上下文情境的中文内容。弹幕不再是随机拼凑的伪字符,而呈现出真实用户即时互动的鲜活感。若论尚存提升空间,或在于字体渲染——中文字体偶有不够规整之处,尚未完全复刻操作系统级字库的像素级精度。但必须强调:这已不再是“AI写不出中文”的底层缺陷,而是进入更高阶的“如何更自然地呈现中文”的优化阶段。
这一跃迁意义非凡。
当人物动态自然、界面逻辑自洽、文字清晰可读、像素质感统一,这张图便超越了“生成图像”的范畴,开始具备“可信现场”的属性。它看起来就像从某台手机中直接截取的画面,像是某个直播间里真实闪现过的一帧——也正是这种扑面而来的临场感,让人真切意识到:AI图像生成,真的迎来拐点了。
站在2026年的当下,我们或许不得不承认一个事实:单凭一张图,已无法断定它是真实拍摄、后期修图,抑或由AI从零构建。
昔日信奉“眼见为实”,后来接受“图可伪造”,而今我们面临的新命题是:有些图像既无原始拍摄现场,也无摄影师参与,更无那一秒的真实发生,却拥有足以乱真的时空质感。
写在最后
GPT-image-2最核心的突破,不在于画得更美,而在于它真正读懂了用户的意图,并据此作出符合现实语境的综合判断。它理解直播间应有的视觉语法,知晓中文信息在数字界面中的呈现逻辑,也明白一个活在具体平台、具体界面、具体使用习惯中的人,该以何种状态存在。
这种语义级理解力,远比单纯提升画质更具战略价值。
未来真正具备竞争力的图像生成能力,或将不再聚焦于“是否好看”,而转向“是否可信”。电商主图、社交平台截图、产品功能演示、教学步骤界面、内容封面、短视频素材、广告视觉方案,乃至尚未被定义的新型视觉表达形式,都将被这种能力重新塑造。
如你想亲自体验,可访问Arena.ai,进入Battle模式选择图像生成对战。多刷新几次,系统将以匿名方式随机分配模型,有一定概率匹配到该灰度测试版。它未必每次现身,但只要命中一次,你大概率就能切身感受到——它为何与众不同。
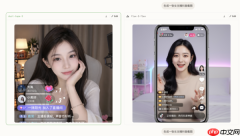
一眼高下立判
目前来看,该模型尚未大规模开放。推测原因有二:一是推理负载压力巨大;二是此类高度拟真的生成能力一旦全面铺开,将引发前所未有的应用场景复杂性与安全治理挑战。此前Google凭借Nano Banana Pro推动Gemini图像能力圈粉无数,如今OpenAI也亮出了自己的关键答卷。
这一次,它无需冗长发布会铺垫,也不靠参数堆砌说服。
它只用一张图,就完成了全部表达。
高度拟真、文字准确、像素一致、界面可信、人物生动。最关键的是,它所产出的内容,已基本褪去浓重的AI痕迹。当你第一眼看到它,脑海浮现的念头只会是:这一定是一张真实截图。
这才是最令人屏息之处。
过去我们感叹:AI竟能画成这样。
今天,我们怔住:这居然是AI画的?








