





proxy_next_upstream 是 Nginx 实现后端高可用的关键机制,仅对 timeout、error、http_500/502/503/504、invalid_header 等可重试错误触发重试,需配合 proxy_next_upstream_tries、proxy_next_upstream_timeout 及健康检查使用。
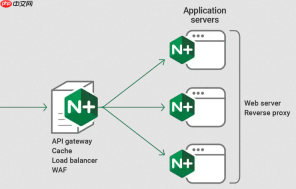
Nginx 的 proxy_next_upstream 是实现后端服务高可用的关键机制,它让请求在上游节点异常时自动转发给其他健康节点,无需客户端重试。但要注意:它只对“可重试”的失败类型生效,并不改变负载均衡的初始选择逻辑。
哪些错误会触发重试?
默认情况下,Nginx 仅在以下情况尝试下一个 upstream server:
-
timeout:与后端建立连接、发送请求或读取响应超时(需配合
proxy_connect_timeout、proxy_send_timeout、proxy_read_timeout使用) - error:网络层面错误,如连接被拒、断连、DNS 解析失败等
- http_500 / http_502 / http_503 / http_504:明确返回这些状态码时可配置重试(需显式写出)
- invalid_header:后端返回了非法 HTTP 响应头(如空行前有乱码)
注意:http_404、http_403 等客户端错误不会触发重试,因为它们通常表示业务逻辑问题,重发无意义。
如何正确配置重试行为?
关键配置需放在 location 或 server 块中,作用于具体 upstream 调用:
location /api/ {
    proxy_pass http://backend;
    proxy_next_upstream error timeout http_502 http_503 http_504;
    proxy_next_upstream_tries 3;          # 最多重试 2 次(共 3 次请求)
    proxy_next_upstream_timeout 10s;      # 整个重试过程总超时
}
说明:
-
proxy_next_upstream_tries控制最大尝试次数(含首次),设为 3 表示最多选 3 个不同节点 -
proxy_next_upstream_timeout是从第一次发起请求开始计时,超时即终止重试并返回错误 - 若所有节点都失败,Nginx 返回最后一个节点的响应(如 502)或超时错误
和健康检查配合使用才真正可靠
proxy_next_upstream 是“请求时兜底”,不是“提前规避”。它无法感知节点是否已宕机,每次请求仍可能先打到坏节点。因此必须搭配主动健康检查:

- 使用
upstream_check_module(需编译添加)做 TCP 或 HTTP 层心跳检测 - 或用 Nginx Plus 的原生
health_check指令 - 开源版可结合
max_fails+fail_timeout实现被动摘除
例如:
upstream backend {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
}
这样当某节点连续 3 次因 proxy_next_upstream 触发的失败被记录后,会在 30 秒内不再被选中,减少无效重试。
常见误区与注意事项
容易忽略但影响实际效果的细节:
-
POST 请求默认不重试:除非显式加上
http_502等,否则非幂等请求不会自动重发(避免重复提交) -
超时时间要分层设置:
proxy_connect_timeout应小于proxy_next_upstream_timeout,否则重试逻辑可能不生效 -
日志中看不出重试过程:Nginx access log 只记最终响应,需开启
error_log notice查看重试动作 -
不支持跨 upstream 重试:只能在同一个
upstream块内轮询,不能 fallback 到另一个 upstream 组
合理设置 proxy_next_upstream 能显著提升接口容错能力,但不能替代合理的服务治理设计。


