





nginx worker异常退出后,master进程会自动拉起新worker,但需确保master存活、配置正确及资源充足;残留共享内存、socket文件和临时文件需手动清理;建议配置core dump、健康检查、systemd重启策略及日志监控以增强稳定性。
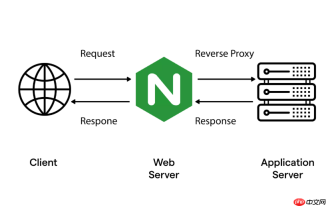
当 Nginx 的 worker 进程异常退出时,系统不会自动清理残留资源(如共享内存、临时文件、socket 文件等),也不会自动拉起新进程,需依赖主进程的监控机制与外部配置协同完成自愈。关键在于理解 Nginx 的进程模型、异常退出的常见诱因,以及如何通过配置和运维手段保障稳定性。
Worker 异常退出的典型原因
worker 进程并非独立运行,而是由 master 进程 fork 并监管。常见异常退出场景包括:
- 处理请求时触发段错误(如第三方模块 bug、内存越界)
- 被系统 OOM Killer 终止(内存超限,/var/log/messages 中可查)
- 收到非法信号(如 kill -SEGV 或误发 SIGKILL)
- worker_connections 耗尽且未配置 proper timeout 或队列限制,导致僵死或崩溃
- 使用不兼容的动态模块,或在 reload 时模块初始化失败
Master 进程的默认自愈行为
Nginx master 进程会持续监控 worker 状态。只要未显式停止(如 nginx -s stop),且配置未破坏,master 在检测到 worker 异常退出后会立即 fork 新的 worker 进程替代——这是内置机制,无需额外配置。
但该机制有前提:

- master 进程自身必须存活(不能被 kill -9 或 OOM)
- nginx.conf 语法正确,且无启动阶段阻塞(如 upstream 解析失败、ssl_certificate 不可读)
- 系统资源充足(可用 PID、内存、文件描述符)
可通过 ps aux | grep nginx 观察 master 是否仍在,以及 worker 数量是否快速恢复。
残留资源的手动清理要点
若 worker 崩溃前已创建共享内存区(如 limit_req_zone、ssl_session_cache)、持有 unix socket(如 proxy_pass 到本地 socket)、或生成临时文件(client_body_temp_path 下),这些资源可能不会被自动释放:
- 共享内存段:用 ipcs -m 查看,Nginx 重启后旧段通常被忽略,但长期运行中积累可能导致 key 冲突;建议重启前执行 nginx -s stop(优雅终止,master 会清理 shm)
- unix socket 文件:若 upstream 使用 socket 路径(如 fastcgi_pass unix:/var/run/php.sock),崩溃后 socket 文件可能残留但无监听进程;删除前确认无其他服务占用,再 rm -f /path/to/socket
- 临时目录文件:client_body_temp_path、proxy_temp_path 等路径下残留文件不影响运行,但可定期用 find /path -type f -mmin +60 -delete 清理过期项
增强稳定性的实用配置建议
减少异常发生概率,并加快故障收敛:
- 设置 worker_rlimit_core on + working_directory /var/core,配合 ulimit -c unlimited,便于崩溃后分析 core dump
- 启用 daemon off(仅调试)或容器化部署时用 master_process off,简化进程模型
- 配置 worker_shutdown_timeout 30s,避免 reload 时 worker 拖延退出
- 对关键 upstream 添加 max_fails=2 fail_timeout=30s,防止雪崩传导至 worker 崩溃
- 在 systemd 中启用 Restart=always、RestartSec=5,并设 LimitCORE=infinity,提升宿主层容错
不复杂但容易忽略的是:确保日志级别足够(error_log /var/log/nginx/error.log warn;),并定期检查 error.log 中的 “signal 11”、“segmentation fault”、“could not build the server_names_hash” 等关键词——它们往往是 worker 异常退出的第一线索。


