





通过分析nginx反向代理日志中$upstream_status状态码的波动(尤其是5xx/4xx比例突增),结合专用日志格式、实时统计、多维交叉验证及分级告警,可主动发现上游异常。
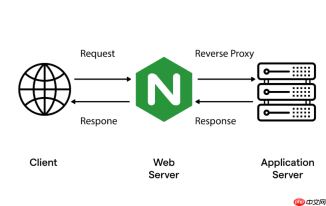
通过分析 Nginx 反向代理日志中的状态码分布变化,可以快速发现上游服务异常、负载失衡或接口故障等问题。关键不是只看错误数,而是识别“波动”——即短时间内某类状态码(尤其是 5xx、4xx)比例或绝对值的显著上升。
配置精准的日志格式,分离代理响应状态码
Nginx 默认 $status 记录的是返回给客户端的状态码,若启用了错误页面重写或内部跳转,它可能掩盖真实上游响应。应使用 $upstream_http_content_type 和更关键的 $upstream_status(需在 proxy_pass 后启用 upstream 模块并确保配置正确)来捕获后端真实返回码。
推荐在 http 块中定义专用日志格式:
log_format upstream_log '$remote_addr - $remote_user [$time_local] '"\"$request\" $status $body_bytes_sent "
"$upstream_addr $upstream_status $upstream_response_length "
"$upstream_response_time $request_time';
然后在 location 或 server 块中启用:
access_log /var/log/nginx/proxy_upstream.log upstream_log;
用脚本/工具实时统计状态码趋势
单纯翻日志效率低。可每分钟执行一次轻量统计,聚焦最近 60 秒日志行:

- 用 awk 提取
$upstream_status并按 2xx/3xx/4xx/5xx 分组计数 - 对比前 1 分钟与前 5 分钟的 5xx 占比:若从 0.2% 升至 8%,触发告警
- 对 502/503/504 单独计数——502 多为后端进程崩溃,503 常见于上游限流,504 则指向超时配置不合理
关联时间窗口与业务指标交叉验证
状态码突增需排除误报。例如:
- 凌晨批量任务调用大量失败接口,可能伴随请求量骤降,属预期行为
- 若 5xx 上升同时
$upstream_response_time中位数翻倍,大概率是上游性能瓶颈 - 同一 upstream server 的 5xx 集中爆发,而其他节点正常,说明该实例已失联或过载
建议将 Nginx 日志状态码统计结果,与 Prometheus + nginx-vts-exporter 的指标(如 nginx_vts_upstream_response_codes_total)做时间对齐比对,增强判断可信度。
设置分级告警与自动快照机制
避免“一异常就告警”造成疲劳。可设定:
- 一级:5xx 占比 > 3% 持续 2 分钟 → 企业微信静默通知运维群
- 二级:502/503 单码数量突增 5 倍且 > 50 次/分钟 → 电话告警 + 自动保存当前 upstream 状态(
curl http://localhost:8080/status)和最近 100 行 upstream 日志 - 三级:连续 3 次检测到同一 upstream server 的 5xx 独占 90%+ → 自动触发临时摘除该 server(需配合动态 upstream 脚本)
不复杂但容易忽略。核心是让日志说话,而不是等用户投诉才行动。


