





实现全球低延迟需Nginx作为区域网关,协同DNS智能调度、Anycast、延迟探测与服务发现;通过GeoIP+实时RTT动态调权,分三层架构(DNS/边缘/核心),用OpenResty+Prometheus闭环优化,并确保真实客户端IP与精准延迟采集。
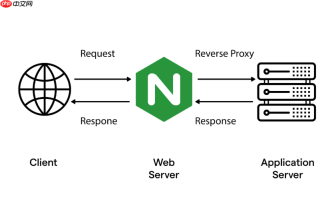
要实现全球业务的低延迟接入,单靠Nginx的普通负载均衡远远不够——它本身不感知用户地理位置、网络质量或后端节点实时健康状态。真正有效的方案,是将Nginx作为边缘或区域级流量代理,与DNS智能调度、Anycast、服务发现及延迟探测机制协同工作。
用GeoIP+延迟反馈做动态权重调整
Nginx原生支持$geoip2_country_code等变量,可结合MaxMind GeoLite2数据库识别用户属地。但仅按国家分流不够精准,需叠加延迟感知:
- 在各区域边缘节点(如东京、法兰克福、圣何塞)部署轻量探测服务,定期向中心上报到核心集群的RTT和丢包率
- 通过API或Consul KV将延迟数据同步至Nginx所在主机,用lua-resty-balancer或自定义upstream模块动态更新server权重
- 示例:东京用户请求到达新加坡Nginx时,若检测到直连上海集群平均延迟为85ms,而经香港中转为62ms,则自动将香港上游权重提升30%
分层部署:Nginx作为区域网关,非全局入口
把Nginx当“全球统一入口”是常见误区。合理架构应分三级:
- DNS层:使用支持EDNS Client Subnet(ECS)的权威DNS(如Cloudflare、AWS Route 53),根据用户IP前缀返回最近的Anycast VIP或区域入口IP
- 边缘层:每个大区(如APAC、EMEA、US)部署一组Nginx+Keepalived高可用集群,仅负责本区内路由、TLS卸载、WAF和本地缓存
- 核心层:跨区域业务逻辑集群,由边缘Nginx按延迟/负载/CPU使用率等指标做二次分发,避免长距离TCP透传
用OpenResty+Prometheus闭环优化延迟
纯静态配置无法应对网络抖动。推荐用OpenResty替代原生Nginx,构建可观测闭环:
- 在access_by_lua_block中记录每个upstream响应时间、SSL握手耗时、首字节延迟(first_byte_time),打标region、upstream_name、status
- 通过nginx-lua-prometheus暴露指标,用Prometheus抓取,Grafana看板实时展示各区域P95延迟热力图
- 设置告警规则:当某区域到某个上游P95延迟突增200%持续1分钟,自动触发Lua脚本临时降低其weight至0,并通知运维介入
注意真实客户端IP与延迟计算的准确性
CDN或多层代理下,$remote_addr可能只是上一跳IP,导致GeoIP误判、延迟统计失真:
- 确保所有前置设备(如Cloudflare、AWS ALB)在X-Forwarded-For或CF-Connecting-IP头中透传原始IP,并在Nginx中用set_real_ip_from + real_ip_header严格校验
- 启用proxy_protocol(v2)对接支持它的LB,比HTTP头更可靠;同时用$upstream_connect_time和$upstream_header_time替代粗略的$upstream_response_time来定位延迟瓶颈
- 对移动端用户,建议在SDK中主动上报GPS经纬度+网络类型(4G/WiFi),回传至边缘Nginx做补充路由决策(需合规脱敏)
不复杂但容易忽略:延迟优化不是堆硬件或调参数,而是让每一层都知道“谁离用户最近、此刻谁最稳”。Nginx是执行者,不是决策者。


