





Nginx负载均衡算法中,轮询开销最低,哈希类次之,least_time最高;轮询仅需计数器取模,加权轮询仍为O(1);ip_hash和hash $request_uri涉及哈希计算,高QPS下占CPU 8%~20%;least_time因共享内存锁竞争,在多核多节点时sys CPU升高。
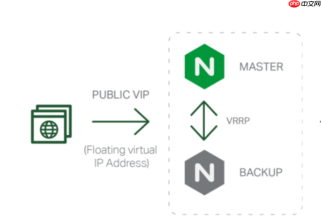
选择合适的Nginx负载均衡算法,直接影响后端节点的请求分发效率和Nginx自身的CPU开销。简单轮询(round-robin)在大多数场景下CPU消耗最低;而复杂策略如基于响应时间的least_time或带权重的哈希(ip_hash、hash $request_uri consistent)会显著增加计算负担,尤其在高并发、高频请求场景下更明显。
轮询与加权轮询:低开销的基础选择
默认的round-robin不依赖任何变量计算,仅维护一个计数器,每处理一次请求递增一次并取模,CPU指令级开销极小。加权轮询(weight参数)虽需累加权重值并做整数比较,但仍在O(1)时间完成,对现代CPU几乎无压力。适合后端节点性能相近、无特殊会话或缓存亲和要求的常规服务。
- 避免在无需权重调度时手动添加
weight=1,虽不影响功能,但触发权重计算路径 - 高QPS(如>5k req/s)下,轮询模式下Nginx worker进程CPU使用率通常稳定在5%~15%
哈希类算法:确定性带来额外计算成本
ip_hash需对客户端IP做32位哈希(IPv4)或128位取前64位再哈希(IPv6),hash $request_uri则每次都要计算URI字符串的哈希值——这涉及内存读取、循环异或/移位等操作。在万级RPS下,哈希计算可能占worker CPU总耗时的8%~20%,尤其URI较长或含动态参数时更明显。
- 若用
hash $remote_addr替代ip_hash,可绕过IPv6兼容逻辑,减少分支判断,实测降低约15%哈希开销 - 启用
consistent参数后,ketama一致性哈希需构建虚拟节点映射表,首次加载upstream时内存和CPU开销上升,但运行时查询为O(log N),比普通哈希略高
least_conn与least_time:实时指标引入系统调用与锁竞争
least_conn需遍历所有active连接数,属轻量比较;但least_time(需配合http_upstream_module编译)必须读取每个server的最近响应时间统计值——该值由共享内存(shared zone)维护,每次选择都触发原子读+可能的自旋锁等待。在16核以上机器、后端server数超32时,锁争用会导致CPU缓存行频繁失效,观察到sys CPU占比升高。
-
least_time建议仅用于后端响应时间差异极大(如跨机房、混合云)且QPS低于2k的场景
实际调优建议:从压测数据出发
不要仅凭理论选算法。用wrk或hey对同一upstream配置不同算法进行对比压测,重点关注nginx -s reload后top中worker进程的%CPU和上下文切换次数(cs列)。例如:某电商API集群在切换至hash $request_uri consistent后,单worker CPU从12%升至34%,同时cs翻倍,最终改用round-robin + 后端本地缓存解决热点URI问题。
- 开启
worker_cpu_affinity auto;绑定CPU核,减少调度抖动对算法开销的放大效应 - 监控
nginx_stub_status中的Reading/Waiting比例,若Waiting偏高,说明事件处理未成为瓶颈,算法优化收益有限 - 对于TLS终止场景,SSL握手开销远高于负载均衡算法本身,此时优先优化证书链、启用OCSP stapling和TLS 1.3
算法本身没有绝对优劣,关键看是否匹配你的流量特征和资源约束。多数情况下,保持默认轮询,把优化重心放在后端处理能力、网络延迟和缓存设计上,反而更有效。



