





最小连接数(Least Conn)是Nginx在请求到达时实时选择健康且活跃连接数最少的上游服务器;它比轮询更适配计算密集型服务,因能避开正处理长耗时任务的节点,降低延迟。
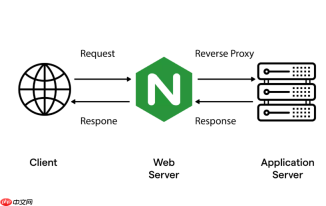
最小连接数(Least Conn)不是简单地“挑个连接少的后端”,而是Nginx在请求到达时,实时比较各上游服务器当前活跃连接数,把新请求发给连接数最少的那个——前提是该服务器处于健康状态且未被手动摘除。
为什么最小连接数比轮询更适合计算密集型服务
轮询不看后端实际负载,容易把请求打到正忙于处理长耗时任务(比如模型推理、复杂报表生成)的节点上,导致响应延迟陡增甚至超时。而最小连接数天然倾向空闲节点,尤其适合单次请求CPU/内存消耗差异大、处理时间不可预测的服务。
例如:两个后端节点,A正在处理3个耗时8秒的AI请求,B刚完成上一个请求、连接数为0。轮询可能继续把第4个请求分给A,而最小连接数会立即导向B,整体平均响应时间下降明显。
配置要点:健康检查 + 连接数权重 + 超时协同
- 必须启用主动健康检查:仅靠默认的失败重试无法及时剔除卡住但未断连的节点。建议配置health_check interval=3 fails=2 passes=2,配合match块校验HTTP状态码和关键响应头
- 用weight调节节点承载能力:若某台机器CPU是其他节点的2倍,设weight=2,Nginx会在连接数相近时优先多分请求过去,避免小规格机器过早打满
- 调整proxy_next_upstream策略:至少包含error timeout http_500 http_502,确保后端因过载返回502或超时时能自动切走,不卡死在故障节点
监控与验证:别只盯“连接数”本身
光看$upstream_addr和$upstream_connect_time不够。需组合观测:
- 各后端的active connections(通过stub_status或Prometheus exporter)是否持续接近上限?若是,说明最小连接数已无法缓解,需扩容或优化后端处理逻辑
- 对比$upstream_header_time和$upstream_response_time:若前者稳定但后者飙升,问题在后端业务逻辑;若两者同步升高,可能是网络或Nginx自身瓶颈(如worker_connections不足)
- 开启log_format记录$upstream_bytes_received和$upstream_cache_status,排除缓存失效引发的重复计算压力
常见踩坑与绕过方案
- 长连接(keepalive)干扰判断:后端维持大量空闲长连接会虚高active connections值。可在upstream里加keepalive 32并配proxy_http_version 1.1; proxy_set_header Connection '';,让Nginx复用连接而非放任后端堆积
- HTTPS后端证书变更未刷新:Nginx不会自动重载SSL握手结果,证书更新后需nginx -s reload或启用ssl_certificate_by_lua_block动态加载
- 最小连接数在低流量下失效:只有2个后端且每分钟仅几个请求时,连接数长期为0或1,调度近乎随机。此时可结合ip_hash保会话,或引入hash $request_uri consistent做轻量级一致性哈希


