





nginx高并发连接优化需统筹events配置、内核参数与监控。应启用epoll、合理设置keepalive_timeout(15s)和keepalive_requests(100)、开启reset_timedout_connection,限制worker_connections≤8192,调优tcp_tw_reuse等内核参数,并通过ss、stub_status等持续监控连接状态。
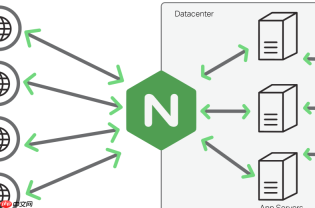
在高并发场景下,Nginx 的 events 块配置直接影响连接的建立、保持与释放效率。默认设置往往无法应对瞬时流量激增或长连接积压,导致连接堆积、TIME_WAIT 升高、端口耗尽甚至拒绝新连接。关键不在“调大数值”,而在于让连接生命周期更可控、更轻量。
启用高效事件模型并关闭不必要的连接保持
Linux 环境下必须显式指定 use epoll(而非默认的 select 或 poll),它支持边缘触发(ET)和就绪队列,大幅降低内核态到用户态的遍历开销。同时,若业务无长连接需求(如纯 API 接口、静态资源服务),应主动缩短连接生命周期:
-
keepalive_timeout 15s;—— 避免设为 0(即禁用 keepalive)或过长(如 65s),10–30 秒较均衡 -
keepalive_requests 100;—— 单连接最大请求数,防止单个慢连接长期占用 worker 进程 - 搭配
reset_timedout_connection on;,对超时未活动的 keepalive 连接主动发送 RST,加速回收
合理限制并发连接数与队列深度
盲目增大 worker_connections 可能加剧上下文切换和内存压力,需结合系统资源与业务特征调整:
- 单个 worker 进程的连接上限建议 ≤ 8192(64 位系统常见安全值),过高易触发 ulimit 限制或内存碎片
-
multi_accept on;—— 允许单次事件循环中接受多个新连接,减少 accept() 调用次数,缓解突发建连压力 -
accept_mutex on;(默认开启)—— 避免多 worker 同时争抢新连接,降低惊群效应;若使用epoll且内核 ≥ 3.9,可考虑关掉以略微提升吞吐(需压测验证)
协同内核参数控制连接状态回收
Nginx 本身不管理 TCP 状态机,TIME_WAIT、FIN_WAIT2 等状态由内核处理。需配合调优避免端口耗尽和连接卡死:
-
net.ipv4.tcp_tw_reuse = 1—— 允许将 TIME_WAIT 套接字用于新 OUTBOUND 连接(对 Nginx 作为反向代理尤其有效) -
net.ipv4.tcp_fin_timeout = 30—— 缩短 FIN_WAIT2 超时时间,加快被动关闭连接的清理 -
net.core.somaxconn = 65535和net.core.netdev_max_backlog = 5000—— 扩大全连接队列与网卡软中断队列,防止 SYN 包丢弃
监控连接状态以验证优化效果
仅改配置不观察等于没调。重点关注三类指标:
-
ss -s查看 total、TCP: time_wait、TCP: established 数量变化趋势 - Nginx 内置 stub_status 模块输出中的
Active connections与Reading/Writing/Waiting分布 —— Waiting 长期 > Active 的 70%,说明 keepalive 设置偏长或客户端异常挂起 -
netstat -n | awk '/^tcp/ {++S[$NF]} END {for(a in S) print a, S[a]}'观察各状态连接数比例,FIN_WAIT1/2、TIME_WAIT 异常升高需回查 upstream 超时或客户端行为
连接释放与回收不是孤立环节,它贯穿 accept → read → process → write → close 全链路。真正有效的优化,是让每个环节的等待变短、判定更准、退出更果断。


