






Nginx默认不因后端响应慢而重试,仅在连接失败、超时或返回502/503/504等错误时按proxy_next_upstream配置重试;需通过缩短proxy_read_timeout将“慢响应”转化为timeout事件来触发重试。
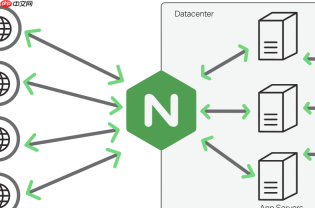
当 Nginx 作为反向代理层时,后端接口响应慢本身不会自动触发重试;Nginx 默认只在连接失败、超时或返回特定错误状态(如 502/503/504)时才按配置重试。要实现“响应慢时的重试”,本质是把“慢响应”转化为 Nginx 可识别的重试条件,核心在于合理设置超时与重试策略。
明确哪些情况会触发重试
Nginx 的 proxy_next_upstream 指令控制重试时机,仅对以下情形生效(需显式配置):
- 连接后端失败(error)
- 向后端发送请求时超时(timeout)
- 从后端接收响应头超时(http_500、http_502、http_503、http_504、http_404 等,需手动列出)
⚠️ 注意:响应体传输慢、后端处理耗时长但最终返回 200,Nginx 默认不重试 —— 因为它认为请求已成功完成。
让“慢响应”进入重试路径的关键配置
思路:缩短 proxy_read_timeout,使后端响应头迟迟未返回时触发 timeout,从而激活 proxy_next_upstream timeout。这是最常用且可控的做法:
- proxy_read_timeout 5s:Nginx 等待后端返回响应头的最长时间。若后端 5 秒内没发回状态行和响应头,Nginx 主动断开并标记为 timeout
- proxy_next_upstream error timeout http_500 http_502 http_503 http_504:明确允许因 timeout 触发重试
- proxy_next_upstream_tries 3:最多重试 2 次(共 3 次请求)
- proxy_next_upstream_timeout 10s:整个重试过程总耗时上限(含首次),超时即返回 502
✅ 效果:后端若 5 秒内无法完成响应头输出(常见于卡在数据库查询、锁等待等场景),Nginx 就会换一台上游重试,避免用户长时间等待单点故障。
配合健康检查,避免无效重试
仅靠 timeout 重试可能把请求打到同样慢或已异常的节点。建议启用主动健康检查:
- 使用 upstream_check_module(需编译)或商业版 Nginx Plus 的 health_check
- 配置周期性探测(如每 3 秒 GET /health),失败连续 3 次则摘除节点
- 结合 proxy_next_upstream ... fail_timeout=30s,临时屏蔽刚失败的节点 30 秒
这样重试时更大概率落到健康的实例上,而非反复打向同一台慢机器。
谨慎对待幂等性与客户端感知
重试会带来副作用,必须评估业务是否可承受:
- 非幂等接口(如支付下单、库存扣减)重试可能导致重复操作,Nginx 层不应自动重试,应由业务层控制
- 若必须重试,建议前端加请求唯一 ID(如 X-Request-ID),后端做去重(如 Redis 幂等表)
- 客户端看到的是单次请求,但实际可能触发多次后端调用;可通过响应头 X-Retry-Count: 2 透传重试次数,便于问题排查
不复杂但容易忽略。


