在信息爆炸的时代,文本分类技术变得越来越重要。无论是分析客户评论的情感倾向,还是自动将新闻文章归类,文本分类都在各行各业发挥着关键作用。本博客将带你使用PyTorch,这个强大的深度学习框架,构建一个功能完善的文本分类器。我们将深入研究自然语言处理(NLP)的核心概念,从词袋模型到更高级的TF-IDF技术,一步步掌握文本分类的精髓。 我们将从最基本的数据准备开始,包括文本预处理、特征提取等环节。然后,我们将使用PyTorch构建一个深度学习模型,并通过真实数据集进行训练和评估。本教程旨在提供详细的代码示例和实战技巧,帮助你不仅理解文本分类的原理,还能将其应用到实际项目中。无论你是NLP初学者还是有一定经验的开发者,都能从本教程中受益。 通过本教程,你将能够构建一个可以准确识别文本情感、主题的分类器,并为未来的NLP项目打下坚实的基础。让我们一起探索PyTorch文本分类的奇妙世界吧!
PyTorch文本分类器构建关键点
文本分类器的构建依赖于PyTorch框架,PyTorch提供了强大的深度学习工具。
自然语言处理(NLP)是文本分类的基础,理解NLP的核心概念至关重要。
词袋模型和TF-IDF是常用的特征提取方法,它们将文本转换为数值形式。
文本预处理包括去除停用词、词干提取等步骤,以提高分类器的准确性。
深度学习模型需要通过真实数据集进行训练和评估。
文本分类器可以应用于情感分析、主题识别等多种场景。
理解文本分类与自然语言处理
什么是文本分类?
文本分类是自然语言处理(nlp)中的一项基本任务,旨在将文本数据自动划分到预定义的类别中。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
这种技术在多个领域都有广泛的应用,例如:
- 情感分析:识别客户评论中的情感是正面、负面还是中性。
- 垃圾邮件检测:将电子邮件分类为垃圾邮件或非垃圾邮件。
- 新闻文章分类:将新闻文章自动归类到体育、政治、科技等主题。
- 主题建模:自动识别文档中的主题和关键词。
文本分类的核心在于将文本信息转换为机器可理解的数值形式,然后利用机器学习算法进行学习和预测。文本预处理、特征提取和模型训练是文本分类的关键步骤,每个环节都对最终的分类效果产生重要影响。
自然语言处理(NLP)的核心概念
自然语言处理(NLP)是计算机科学、人工智能和语言学交叉的一个领域,致力于使计算机能够理解、处理和生成人类语言。
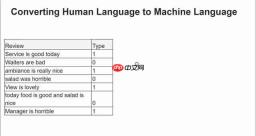
为了构建一个有效的文本分类器,理解NLP的核心概念至关重要:
-
文本预处理:将原始文本数据清洗和转换成适合模型处理的形式。常见的预处理技术包括:
- 去除HTML标签:从文本中移除HTML标签,以减少噪声。
- 去除标点符号和特殊字符:移除文本中的标点符号和特殊字符,以简化文本。
- 转换为小写:将所有文本转换为小写,以避免因大小写不同而导致的问题。
- 去除停用词:移除常见的、对文本分类没有太大意义的词语(如“的”、“是”、“在”等)。
- 词干提取(Stemming):将单词转换为词根形式,例如将“running”转换为“run”,以减少词汇的变体。
- 词形还原(Lemmatization):将单词转换为其基本形式,例如将“better”转换为“good”,以提高文本的规范性。
-
特征提取:将文本数据转换为数值特征,以便机器学习模型能够理解和处理。常用的特征提取方法包括:
- 词袋模型(Bag of Words):将文本看作是词语的集合,忽略词语的顺序和语法,只关注词语的出现频率。优点是简单易懂,缺点是忽略了词语的上下文信息。
- TF-IDF(Term Frequency-Inverse Document Frequency):一种用于评估词语在文档集中重要性的统计方法。TF表示词语在文档中的频率,IDF表示词语在整个文档集中的稀有程度。通过TF-IDF,可以提取出对文档分类具有重要意义的关键词。
- Word Embeddings(词嵌入):将词语映射到低维向量空间,使得语义相似的词语在向量空间中的距离更近。常用的词嵌入模型包括Word2Vec、GloVe和FastText。优点是能够捕捉词语的上下文信息,缺点是计算复杂度较高。
-
模型选择与训练:选择合适的机器学习模型,并使用训练数据进行训练。常用的文本分类模型包括:
- 朴素贝叶斯(Naive Bayes):一种基于贝叶斯定理的分类算法,假设特征之间相互独立。优点是简单高效,缺点是假设过于严格,可能影响分类效果。
- 支持向量机(SVM):一种二分类模型,通过找到最佳的超平面来分隔不同类别的样本。优点是泛化能力强,缺点是对大规模数据集的训练效率较低。
- 深度学习模型(Deep Learning Models):利用神经网络进行文本分类。常用的深度学习模型包括卷积神经网络(CNN)、循环神经网络(RNN)和Transformer模型。优点是能够自动学习文本特征,分类效果较好,缺点是需要大量的训练数据和计算资源。
NLP中常用的特征提取技术:词袋模型与TF-IDF
词袋模型(Bag of Words)
词袋模型(Bag of Words, BoW)是一种经典的文本表示方法,它将文本视为一个无序的词语集合,忽略词语的顺序和语法,只关注词语的出现频率。
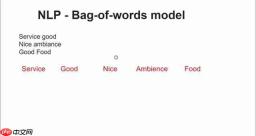
词袋模型的核心思想是将每个文档表示为一个向量,向量的每个维度对应一个词语,维度上的数值表示该词语在文档中出现的次数。
词袋模型的构建步骤如下:
- 构建词汇表:收集所有文档中出现的词语,构建一个包含所有唯一词语的词汇表。
- 创建文档向量:对于每个文档,创建一个与词汇表长度相同的向量。向量的每个维度对应词汇表中的一个词语,维度上的数值表示该词语在文档中出现的次数。
示例:

Word报告自动生成神器。自动生成专业Word文档报告,支持模板填充、目录生成、表格/图表插入、页眉页脚、多级标题、样式主题、批量邮件合并。当用户需要生成Word报告、创建合同文档、批量生成通知/证书、填充Word模板、制作商业计划书时触发。
假设我们有以下三个句子:
- Sentence 1: Service good.
- Sentence 2: Nice ambiance.
- Sentence 3: Good food.
首先,构建词汇表:{Service,Good, Nice, Ambiance,Food},然后,将每个句子转换为词袋向量:
- Sentence 1:
- Sentence 1: [1, 1, 0, 0, 0]
- Sentence 2: [0, 0, 1, 1, 0]
- Sentence 3: [0, 1, 0, 0, 1]
词袋模型的优点:
- 简单易懂,易于实现。
- 计算复杂度低,适用于大规模数据集。
词袋模型的缺点:
- 忽略了词语的顺序和上下文信息,无法捕捉词语之间的语义关系。
- 词汇表的大小可能会非常大,导致向量维度过高,增加计算成本。
- 无法处理未出现在词汇表中的词语(OOV问题)。
TF-IDF(Term Frequency-Inverse Document Frequency)
TF-IDF(词频-逆文档频率)是一种用于评估词语在文档集中重要性的统计方法。
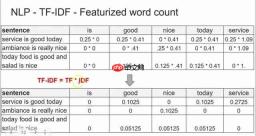
TF-IDF的核心思想是:一个词语在单个文档中出现的频率越高,且在整个文档集中出现的文档数越少,则该词语对该文档的重要性越高。
TF-IDF的计算公式如下:
-
TF(Term Frequency,词频):表示词语在文档中出现的频率。
TF(t, d) = (词语t在文档d中出现的次数) / (文档d中的总词数) -
IDF(Inverse Document Frequency,逆文档频率):表示词语在整个文档集中出现的文档数的倒数的对数。
IDF(t, D) = log(文档集D中的总文档数 / (包含词语t的文档数 + 1)) -
TF-IDF值:
TF-IDF(t, d, D) = TF(t, d) * IDF(t, D)
示例:
假设我们有以下三个句子:
- Sentence 1: Service is good today.
- Sentence 2: Ambiance is really nice.
- Sentence 3: Today food is good and salad is nice.
首先,计算TF值:
| 词语 | Sentence 1 | Sentence 2 | Sentence 3 |