

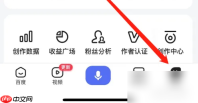
第一步
选择【我的】点击进入;

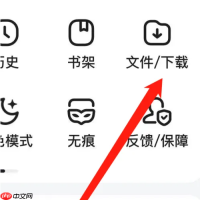
第二步
选择【文件/下载】点击进入;

调用百度PaddleOCR‑VL大模型API,支持PDF、Word、PPT、图片等多格式文档解析,精准识别印刷体、手写体、表格、公式、图表、印章等复杂元素,支持100+语言,可处理不规则布局和跨页长文档。触发词:文档解析、VLM解析、大模型OCR、PaddleOCR、多模态文档、手写识别、公式识别、复杂版面。
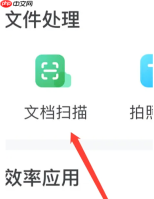
最后
选择【文档扫描】点击进入即可进行扫描。

第一步
选择【我的】点击进入;

第二步
选择【文件/下载】点击进入;
调用百度PaddleOCR‑VL大模型API,支持PDF、Word、PPT、图片等多格式文档解析,精准识别印刷体、手写体、表格、公式、图表、印章等复杂元素,支持100+语言,可处理不规则布局和跨页长文档。触发词:文档解析、VLM解析、大模型OCR、PaddleOCR、多模态文档、手写识别、公式识别、复杂版面。
最后
选择【文档扫描】点击进入即可进行扫描。
相关文章
百度浏览器误关闭的网页标签怎么使用快捷键快速恢复
为什么百度浏览器拦截广告后网页内容出现大片空白
怎样通过百度浏览器把外语网页实时翻译为中文内容
百度浏览器无法运行企业内部ActiveX插件怎么办
百度浏览器如何防止恶意网址劫持当前访问的标签页
相关标签:
百度本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系admin@php.cn

